Group by의 이해
Group by의 개요
Group by 절에 기술된 컬럼 값으로 그룹화한 뒤 집계 함수와 함계 사용
Group by 절에 기술된 컬럼 값이 unique key가 됨
SELECT 절에는 Group by 절에 기술된 컬럼, 집계 함수만 사용 가능
Group by 구문
1
2
3
4
5
6
SELECT <column(s)>
FROM <table>
WHERE <condition>          -- group by 할 컬럼의 filtering 조건
GROUP BY <column(s)>       -- group by 적용할 컬럼명
HAVING <condition>         -- group by 결과의 filtering 조건
ORDER BY <column(s)>;
Group by 적용 예시
- sql의 Group by 젹용 예시
1
2
3
4
5
6
  select deptno, sum(sal) as sum_sal
  from hr.emp
  where job != 'SALARYMAN'
  group by deptno
  having avg(sal) > 2000
  order by deptno;
job이 “SALARYMAN”인 데이터 필터링
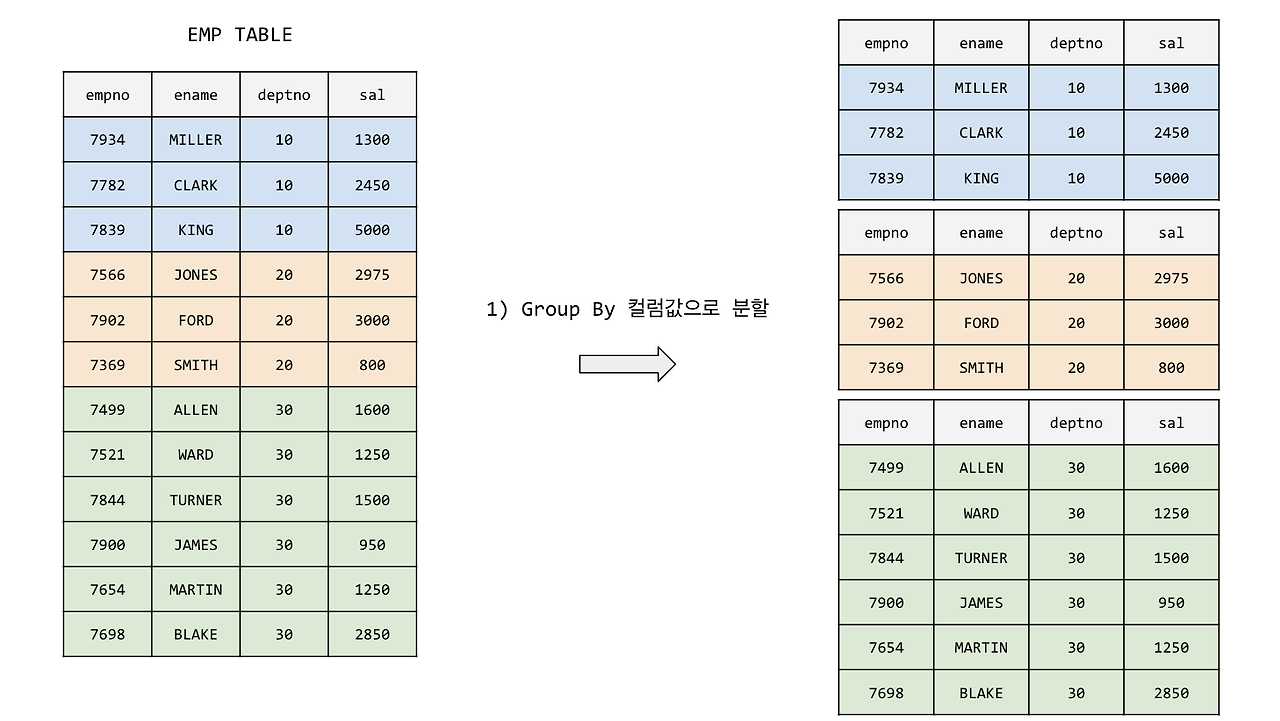
deptno 컬럼으로 그룹화
having 절에 의해 sal의 평균값이 2000 이상인 그룹들로 필터링
Group by 컬럼 값으로 분할
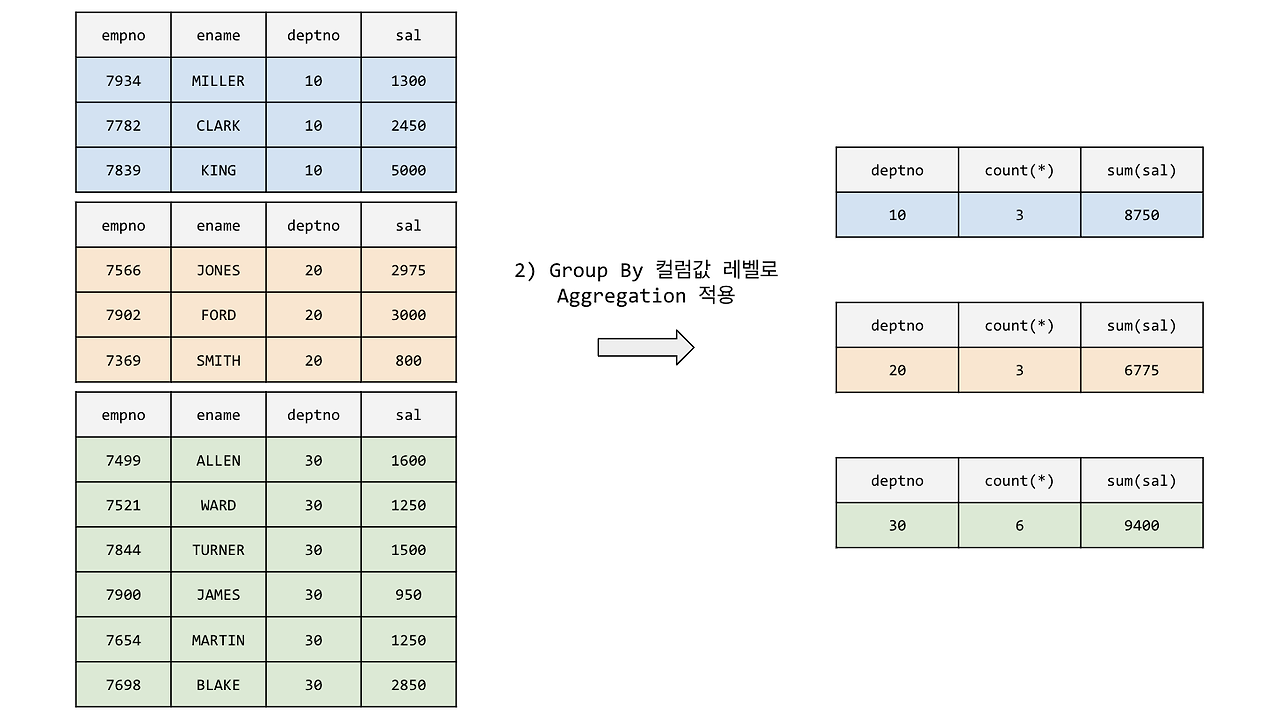
Group by 컬럼 값 레벨로 집계 함수 적용
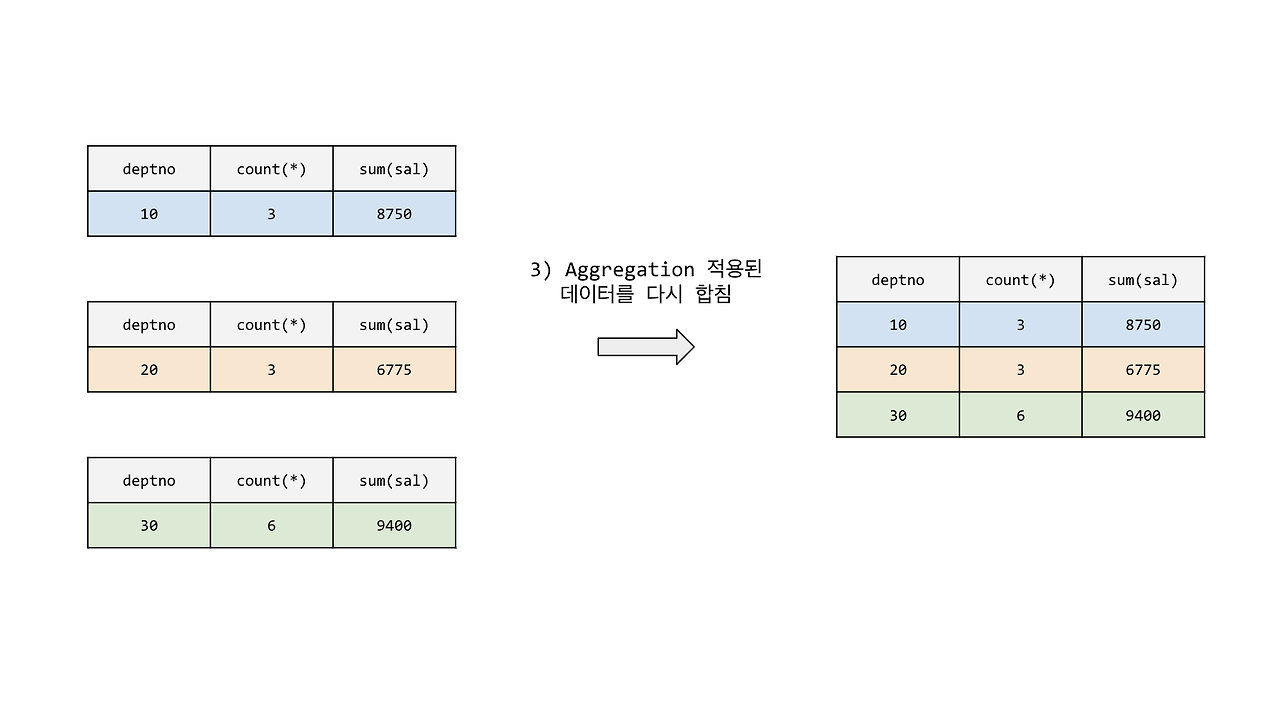
집계 함수가 적용된 데이터를 다시 합침
Group by Rollup의 이해
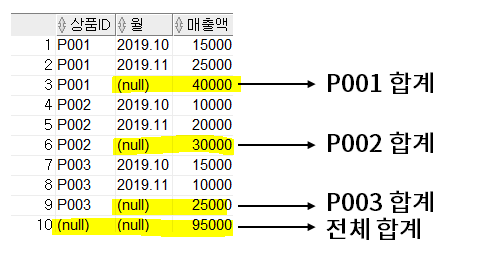
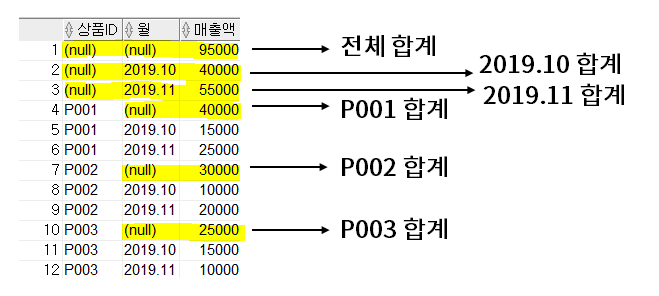
- Group by와 Rollup을 함께 사용하면 Rollup 적용한 컬럼 순서대로 계층적 Group by 수행
1
2
3
  SELECT 상품ID, 월, SUM(매출액) AS 매출액
  FROM 월별매출
  GROUP BY ROLLUP(상품ID, 월);
Group by Cube의 이해
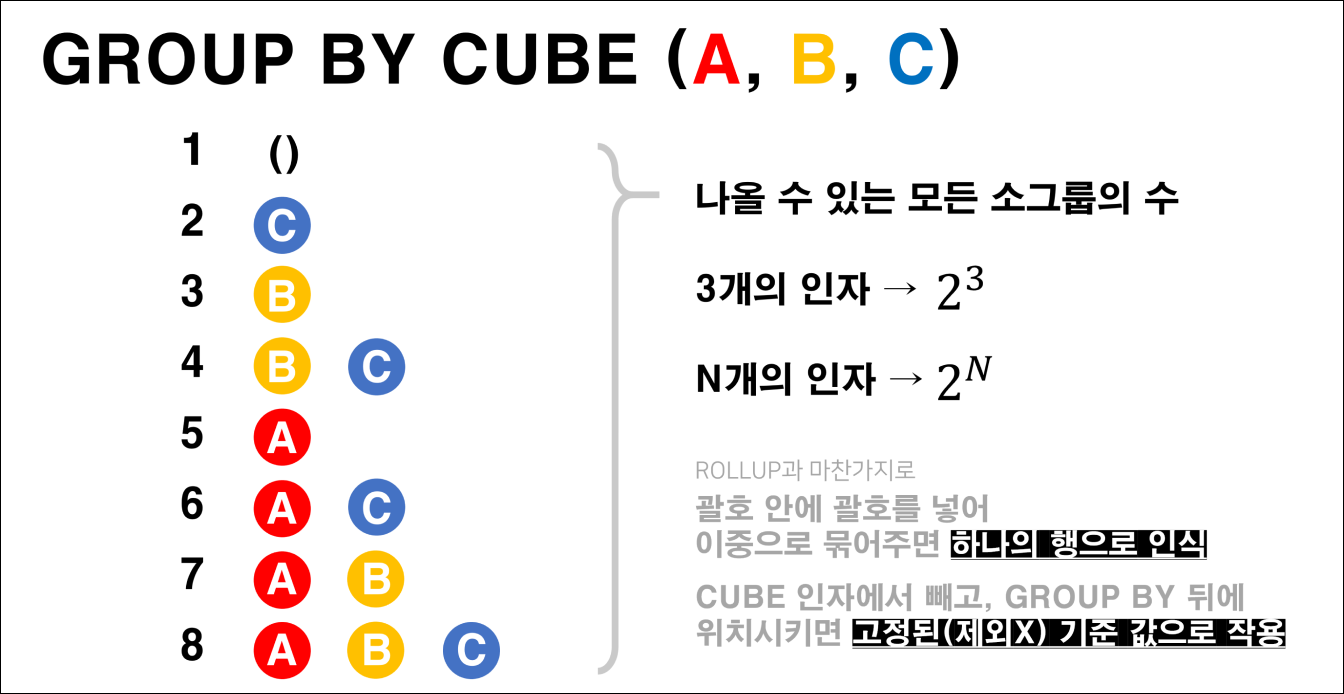
- Group by와 Cube를 함께 사용하면 Cube를 적용한 컬럼 의 가능한 결합으로 Group by 수행
1
2
3
  SELECT 상품ID, 월, SUM(매출액) AS 매출액
  FROM 월별매출
  GROUP BY CUBE(상품ID, 월);
Group by Rollup과 Cube의 적용
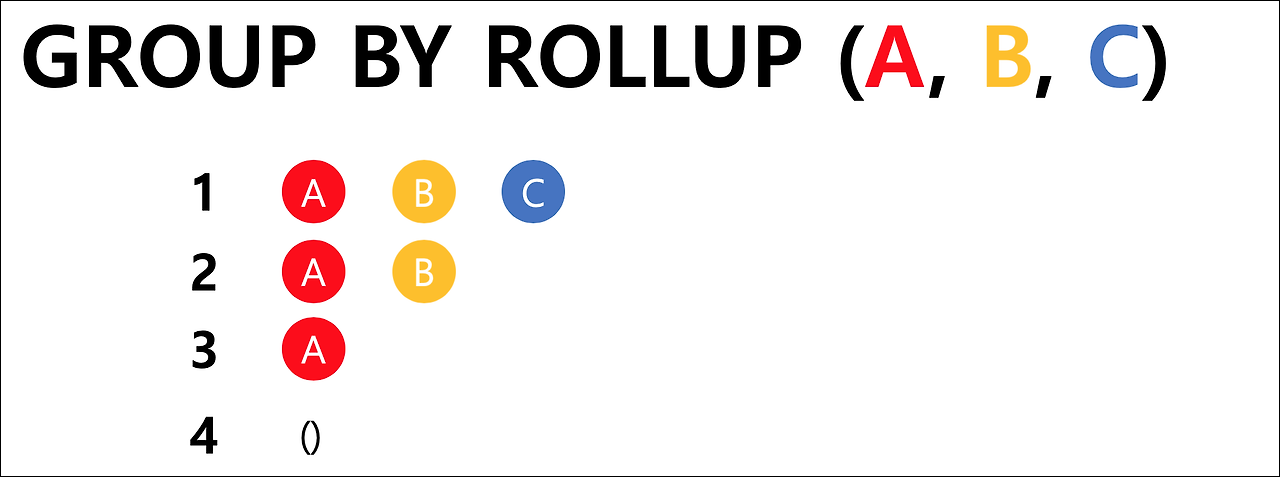
Rollup의 경우, Group by 절의 컬럼 수가 N개면 Group by를 N+1회 수행
Cube의 경우, Group by 절의 컬럼 수가 N개면 Group by를 2^N회 수행
이 기사는 저작권자의 CC BY 4.0 라이센스를 따릅니다.